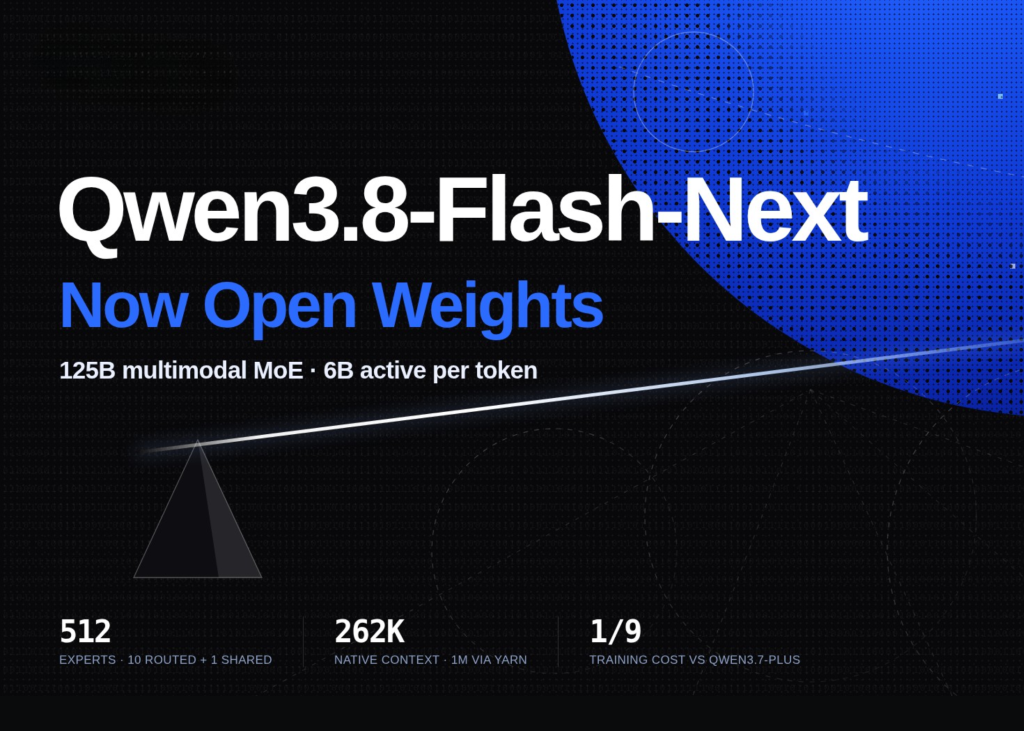
Alibaba’nın yapay zeka ekibi Qwen, devasa kapasitesine rağmen token başına sadece 6 milyar aktif parametre kullanan ve gelecekteki Qwen4 mimarisinin altyapısını oluşturan yeni Qwen3.8-Flash-Next modelini duyurdu.
Alibaba’nın Qwen ekibi, token maliyetini düşürmek amacıyla tasarlanan açık ağırlıklı çok modelli Karışım Uzmanları (MoE) modeli Qwen3.8-Flash-Next‘i duyurdu. Bu yeni model, Qwen3-Next’in Qwen3.5 için oynadığı rol gibi, doğrudan Qwen4 mimarisinin erken bir önizlemesi olarak konumlandırılıyor. Model, 125 milyar parametreli bir omurgayı, 51 milyar parametreli N-gram gömme tablosunu ve 4 milyar parametreli çoklu token tahmin modülünü birleştirerek diske toplamda 180 milyar parametre yazıyor; ancak her bir token için yalnızca 6 milyar parametre aktif hale geliyor.
Yayınlanan teknik detaylara göre mimari dört temel değişiklikle öne çıkıyor: Her dört katmandan üçünde kullanılan Gated DeltaNet ile Qwen Sparse Attention (QSA) hibrit yapısı, 320 daraltma derecesine sahip Gated Residual akışı, katman 2 üzerinde deterministik aramalar yapan N-gram Gömme ve Muon optimizasyon aracı. Model, Qwen3.7-Plus maliyetinin yaklaşık dokuzda biri oranında eğitildi. FP8 kontrol noktası 172.78 GiB ve BF16 kontrol noktası ise 335.28 GiB büyüklüğünde olduğu için standart bir iş istasyonunda çalıştırılamıyor; vLLM ve SGLang tariflerine göre çoklu GPU düğümleri gerekiyor. Qwen3.8-Flash-Next; DeepSWE 1.1 üzerinde 58.7, SWE-bench Pro üzerinde 62.5 ve LiveCodeBench v6 üzerinde 91.9 puan alırken, 262.144 token yerel bağlam uzunluğu sunuyor ve YaRN ile bu kapasite 1.000.000 tokena kadar çıkarılabiliyor.
İlgili yazılar: Liquid AI, Model Çıktılarını Değiştirmeden 3.18 Kat Daha Hızlı Çalışan LFM2.5-DSpark Taslak Modellerini Yayınladı
Görsel ve haber kaynağı: MarkTechPost